qpos[:2] = (1.84, 0.62)近几帧差分 → velocity = 0.71 m/sYSyntheticdrizzle
00%
opening connection
一个人好孤独。
Walking alone feels lonely.我想坐在沙发上
I want to sit on the sofa.CURRENT PROGRESS / ENCOUNTER
PROJECT FLOW
Bringing virtual humans into rooms to interact with furniture.
01Single-agent path planning finds a clean route through the room.
02Planner emits static routes; downstream coordination predicts conflicts and keeps bodies apart.
03An adapter turns planner paths into MotionBricks navigation control.
04MotionBricks generates the final G1 walking animation for export.
又见面了,我想在大house里走路
I want to walk inside the big house.ENTER THE ROOM
01.1THE REQUEST
Single Path Planning
Extract walkable floor, erode the walkable area by the body radius (person as a cylinder), then run A* on the safe grid.
The result is simplified into a clean route before MotionBricks ever starts walking.
我想走到那里去,但是途中不能碰到任何家具。
Find a safe route through the furniture.TARGET / A
01.2REMOVE THE OBSTACLES
SCENE→NAVIGATION
ROOM MESHSTATIC OBSTACLESWALKABLE FLOOR
01.3SHORTEST VALID PATH
PATH FOUND
提取可行走区域;寻路时把人看作有半径的圆柱,只有圆心能容纳整个人时格子才可走;A* 搜路并简化后,以世界坐标输出这条无碰撞路线。
01.4FOLLOW THE ROUTE
POSITION + ORIENTATION + MOTION
A SMALL INTERRUPTION
01.5FIVE STARTS / FIVE GOALS
MULTI-AGENT COORDINATION
多人协调:realtime tick 实时监督
规划器默认 single_agent_static,只交付各自的静态主路线;多人协调由 realtime tick 监督器完成——每 1/30 秒读取所有人实际生成的 root,预测未来 1.8 秒的占用,按优先级决定谁让行。
让行手段是分档降速(1.0 / 0.72 / 0.0)、原地等待或小角度侧移,带迟滞释放与加减速限制,从不编辑已生成的动作帧;离线的 departure_reservation 起点预约 + 从第 0 帧重跑保留为对照基线。
AGENT 01AGENT 02AGENT 03AGENT 04AGENT 05
02.1SOFA REQUEST
02.2CAMERA ARC
02.3VIDEO GENERATION
02.4BODY RECONSTRUCTION
TECHNICAL IMPLEMENTATION / PART ONE
Path planning becomes generated motion.
0001-0377.mp4 / PATH-DRIVEN G1 MOTION
PATH PLANNING / INPUT ADAPTER / MOTION GENERATION
从可行走空间到 MotionBricks 可执行控制。
01提取安全可走区USD 场景栅格化;人按圆柱处理,erode_for_circle 收缩可走区
02A* 搜路 + 视线简化每个 agent 得到一条绕开家具的参考主路线
03静态主路线,动态交给下游多人协调由 realtime tick 监督完成;RVO 风格避让仅作 legacy 备选
04路径翻译成导航条件30 FPS 重采样;每帧读真实 root,闭环生成短期目标与朝向
05MotionBricks 生成动作官方链路不改:full_navigation_agent → VQVAE decoder → G1 动作 NPZ
PLANNING_CORE.PY / PLAN_MULTI.PY
从场景几何生成安全路线
这一页不展示“手画路径”,而是把 USD 房间压成可计算的俯视网格:先得到身体圆心能放下的位置,再在安全余量里找路线。
outputsimplified polyline + sampled path→next input
WHAT THE CODE IS DOING
静态层先回答:身体圆心可以经过哪里?
- 地面提取
planning_core.py 读取 OpenUSD,按场景 upAxis 筛出近似水平的 Mesh face,再投影成俯视 2D 三角形;没有指定 mesh 时选面积最大的水平地面。
- 安全圆心地图
人不是点,而是有半径的圆。规划半径 = max(人物半径, G1 最小半径 0.25m) + MotionBricks 跟踪安全余量 0.08m,再叠加 clearance(默认 0.12m)与半个格子对角线,由 erode_for_circle 收缩可走区,只保留“圆心放在这里不会漏出地面”的格子。
- 偏好宽路的 A*
clearance_preferred_astar 仍然追求短路,但会用 distance transform 加一个 preference_weight / clearance² 的小惩罚,让路径更愿意走在通道中间。
- 去掉栅格锯齿
A* 出来的格子路线再用 segment_is_clear 做 line-of-sight 简化,能直连的拐点就删掉,最后再做静态和扫掠碰撞复核。
MOTIONBRICKS_PATH_DELIVERY
一条静态路径,怎样变成第 k 帧的动作条件?
Planner 为每个人输出带时间、位置和速度的安全中心轨迹;适配层将它插值、平滑为 30 FPS 控制路线,再转换到以起点为原点的局部坐标。运行时每帧读取模型实际 root 并更新路径跟踪与安全状态;过滤后的控制只在生成边界提交。
- 先把路线变成连续时序
motionbricks_path_adapter.py 读取每个 agent 的 times、positions_xy、velocities_xy、speeds 和 actions,插值、平滑成 30 FPS PathTrajectory;ClosedLoopPathController 再减去起点 origin_xy,得到局部控制路线。
- 第 k 帧先读真实结果
get_next_frame() 取出当前 G1 qpos;qpos[:2] 是已经生成的局部 root 位置,最多用最近 3 帧差分得到 measured velocity。控制器在当前进度窗口内寻找最近路线采样点,而不是假定人物严格贴着规划线走。
- 闭环控制生成名义意图
planner_control_bridge.py 把“规划速度 × 1.5 秒”换算为前视距离,并限制在 0.35–1.50m;再结合路线切线与横向误差,得到 movement_direction、facing_direction、名义速度状态和短期目标。它不硬改 root。
- 实时避障过滤这组条件
navigation_safety.py 先用默认 0.9 秒窗口检查静态走廊;realtime_tick_supervisor.py 再汇总所有 NavigationIntent,在默认 1.8 秒窗口内检查人物占用。冲突时减速或等待;对静止阻挡者可尝试安全的小角度绕行,不改已生成姿态。
- 动作输出成为下一帧反馈
系统每帧观察 qpos,但控制只在生成边界提交给 full_navigation_agent。默认 controller_dt = 16/30 秒,一组命令保持约 16 帧;新 root 与实测速率逐帧反馈,关节位置和旋转在保存 NPZ 时由 qpos 转换得到。
from plannertrajectory samples+actual root feedback
ONE FRAME / SOURCE-ALIGNED EXAMPLEFRAME k / 1⁄30 s示意值只用于解释字段关系 01 · 读取生成状态actual local root 02 · 对齐规划路线nearest sample + lookahead 03 · 多人安全监督未来 1.8 s 有占用冲突 04 · 提交给模型MotionBricks control
规划器时序输出 / paths.jsonagent_03 · 世界坐标中心轨迹
t, position_xy, velocity_xy, speed, action轨迹适配30 FPS 插值 + 平滑→减去 origin_xy→局部控制路线
progress → target (2.58, 0.91)得到 direction、facing 与名义状态WALK → SLOW · target scale 0.72只改导航条件,不改已生成关节direction + facing + mode + context控制保持到下一生成边界动作缓冲逐帧输出qpos;保存时转换 joints / rotations↺下一帧重新读取真实 root
outputfiltered navigation condition + root feedback→MotionBricks
WHAT MOTIONBRICKS ACTUALLY IS
条件式 G1 动作生成链
导航意图 + 已有动作上下文 → 下一小段连续 G1 动作
不是路径规划器不是逐关节 IK不是动作片段拼接
外部条件 + 模型已有上下文方向 / 朝向 / mode + frame buffer;速度与精确目标可选
full_navigation_agent组织下一次递归生成所需条件
root model预测身体整体怎样平移和转向
pose model递归生成与 root、控制一致的姿态 token
VQVAE decoder解码动作特征;表示转换器输出 G1 qpos / joints
MODEL ROLE / FOR A FIRST-TIME VIEWER
MotionBricks 在项目中负责什么?
它是 NVIDIA GR00T-WholeBodyControl 中面向 Unitree G1 的学习式、条件式动作生成链。它不理解房间网格,也不替我们规划路线;它擅长的是在已有动作上下文上,递归生成“既服从导航意图、又像连续人体运动”的下一段动作。
- 它消费的是意图
官方接口支持 movement_direction、facing_direction、mode,以及可选的 target_vel 和 specific targets;当前默认 realtime 只提交方向、朝向、mode 与动作上下文,不手工指定膝盖或手臂角度。
- 它保留动作上下文
多人 runner 共享一套官方模型,但为每个人保存独立的 frame buffer、model_features 与读取游标;官方链路递归生成短时动作,因此更新控制时不需要从第 0 帧重播或硬拼动作片段。
- root 与 pose 分工
root model 先预测整体 root 轨迹与生成长度;pose model 再生成与 root、导航条件一致的姿态 token;VQVAE 解码动作特征,随后由动作表示与骨架转换器得到 G1 qpos 和关节运动。
- 控制与生成不是同一频率
场景监督每 1/30 秒读取一次真实状态,但默认 controller_dt = 16/30 秒:模型持续消费已有动作缓冲,到生成边界才接受一组保持一致的新控制,避免每帧抖动。
- 输出也是反馈传感器
每帧本地 qpos[:2] 作为下一轮闭环的 actual root,最多用最近 3 帧差分得到 measured velocity;保存时再转换并写入 34 关节位置、旋转、规划/控制轨迹与安全诊断,供验证和 Blender 烘焙。
TECHNICAL IMPLEMENTATION / PART TWO
From an empty scene to a human presence.
PART TWO / MINIMAX H3 IMAGE CONDITION TEST
输入四张场景图片与一张人物在场景中的姿势参考图。
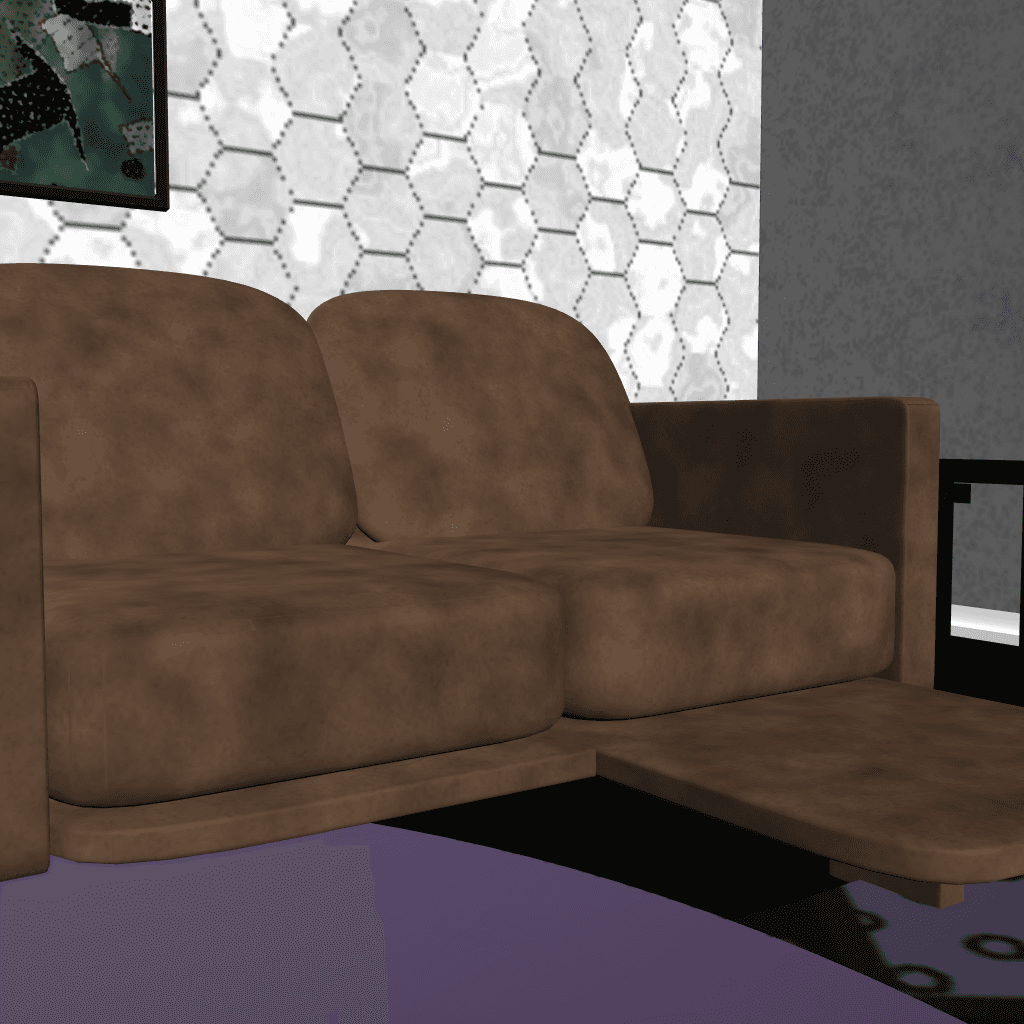
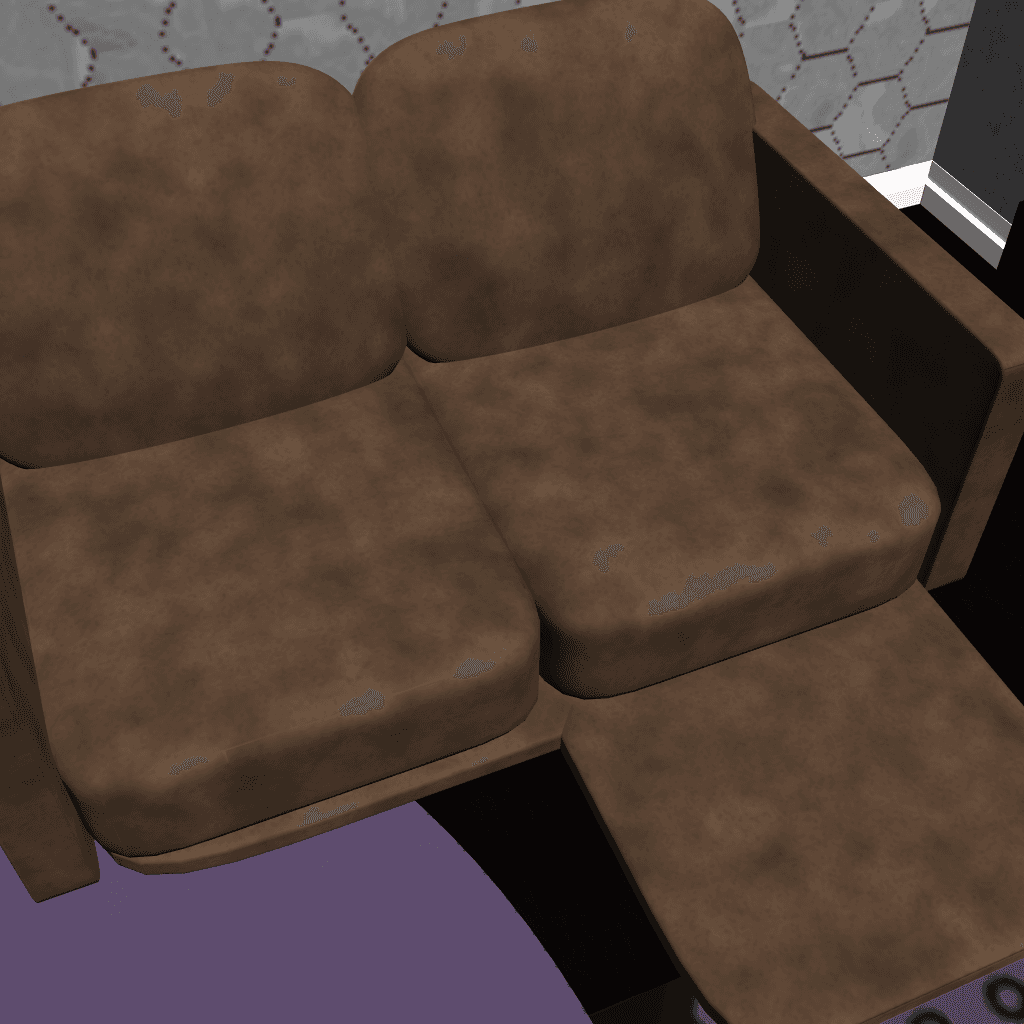
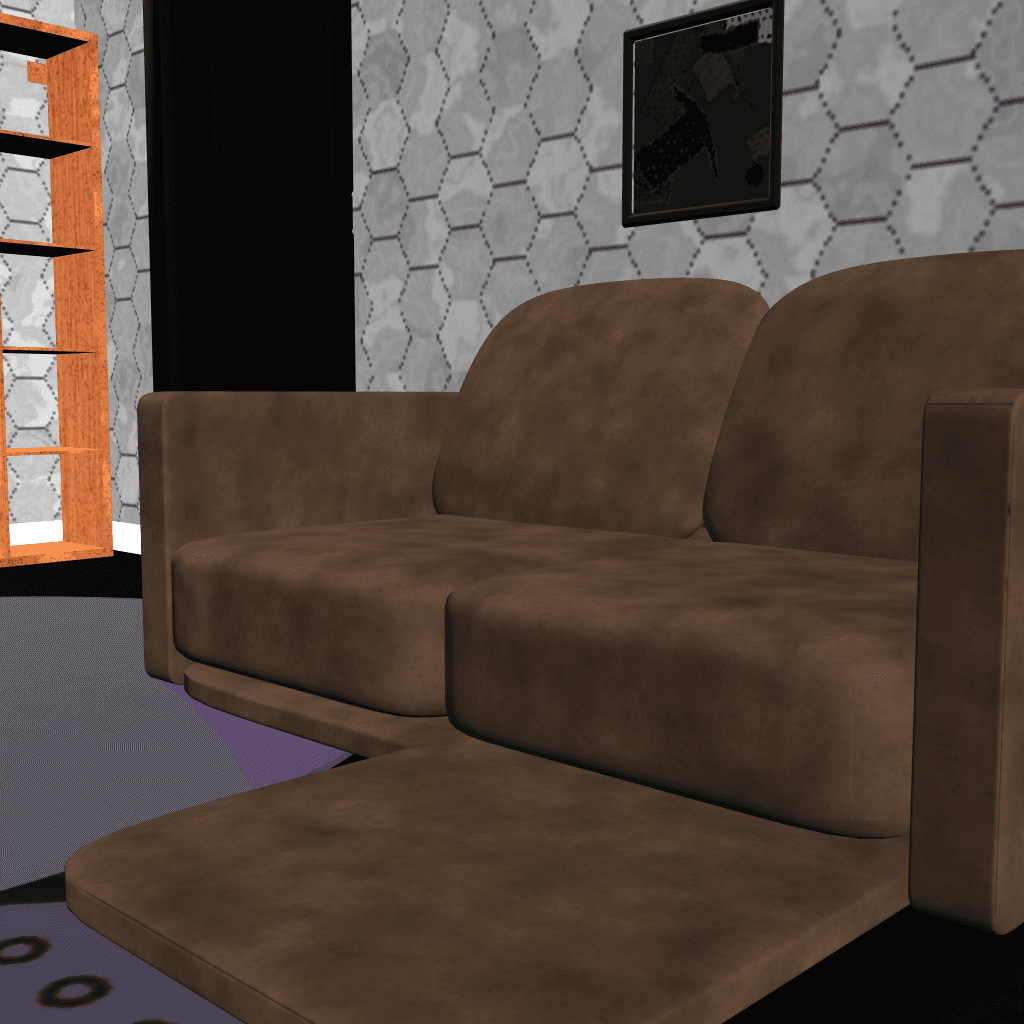
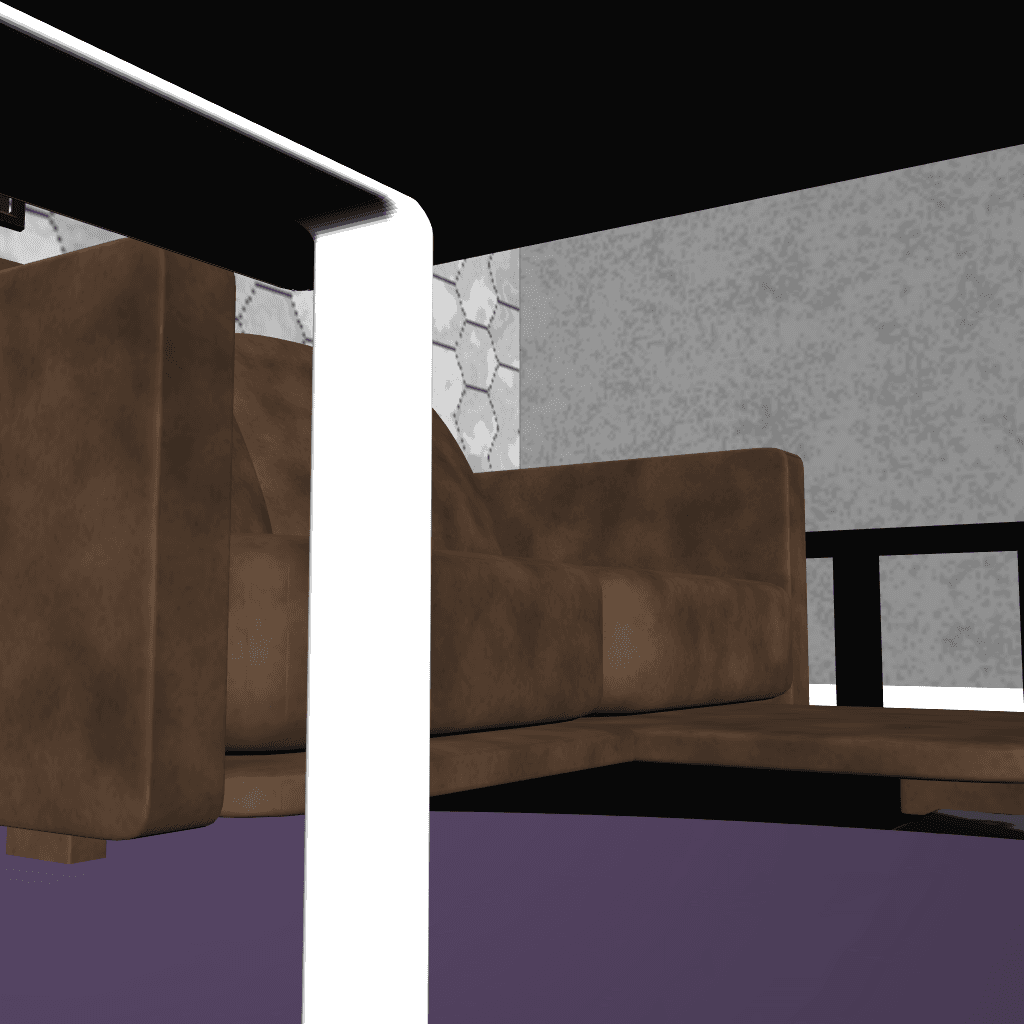
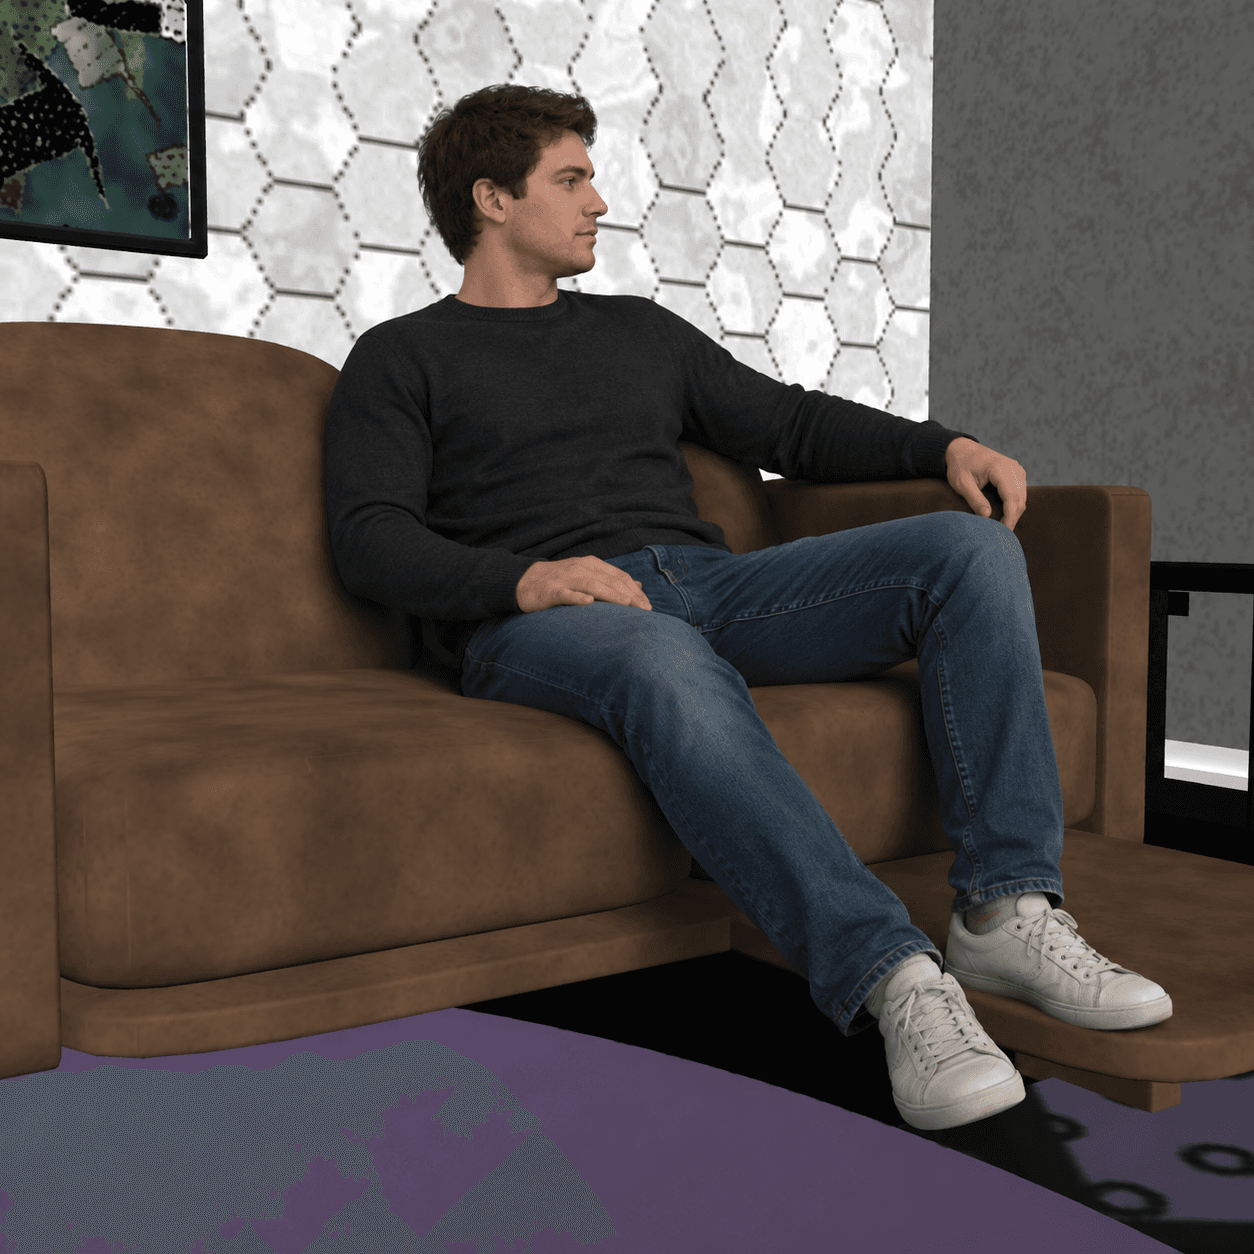
GENERATED CAMERA MOVE / output.mp4
FFMPEG / SAM3 / VIEW MATCHING
从生成视频里找回能继承相机参数的帧。
- 先用 ffmpeg 以 rawvideo 管道流式解码 MiniMax 输出视频(仅选中帧落盘 PNG),给每张输入 view 建立候选时间窗。
- 粗筛阶段比较颜色与结构梯度,但丢掉误差最大的前景 patch,避免人物遮挡影响判断。
- SAM3 分割并排除人物区域后,再用背景几何验证确认家具与墙面没有漂移。
- 最终一对一选择 video frame,使每个 view 都能继承原 cameras.json 里的 K / R / T 与 camera_id。
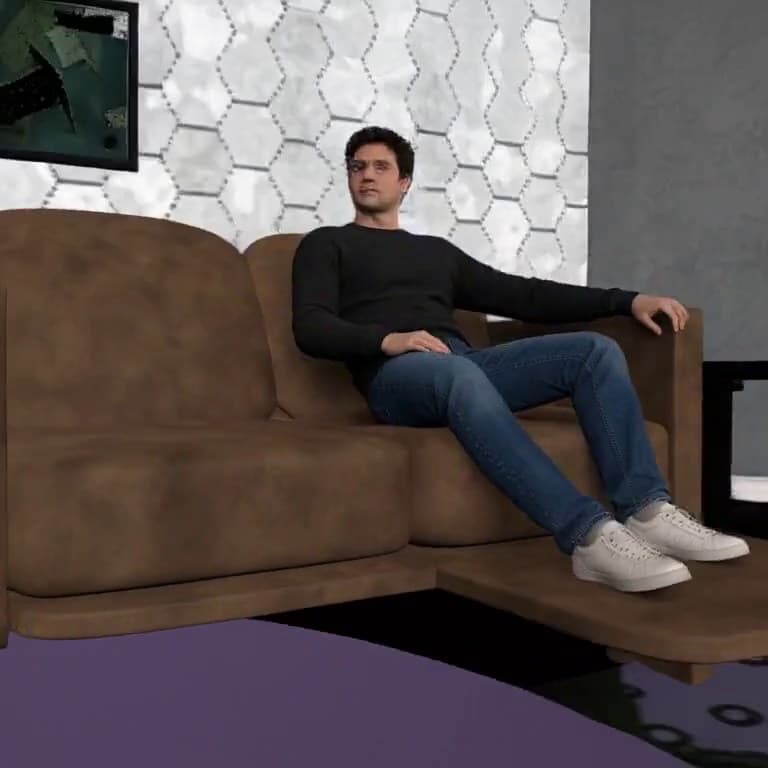
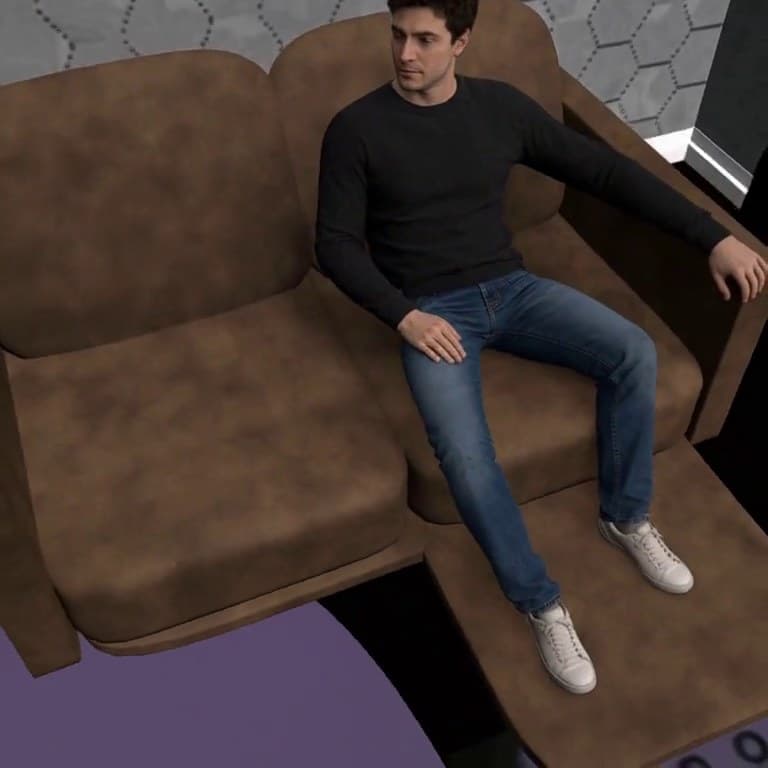
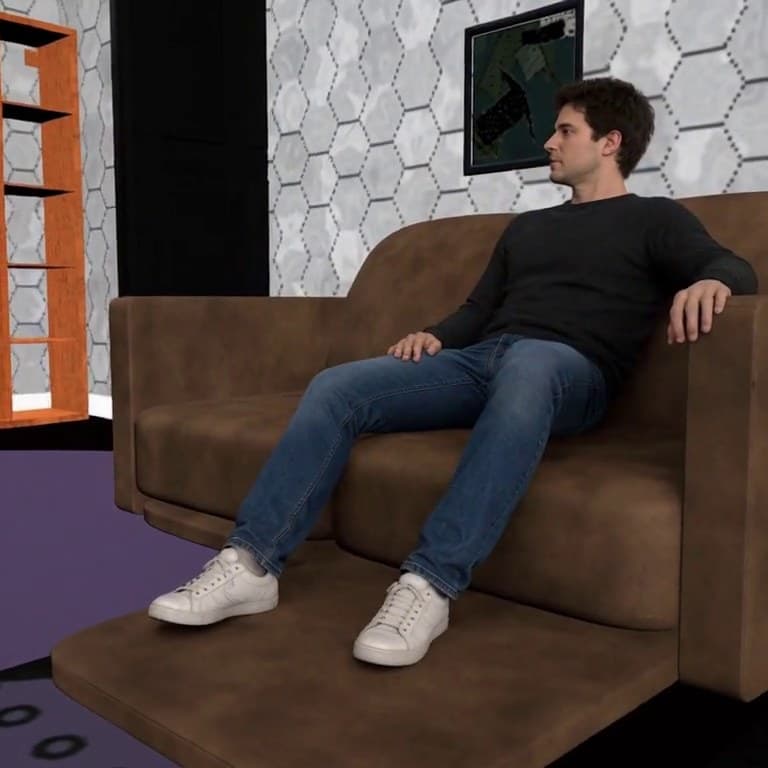
ROBUST_PATCH_SCORE / COARSE PASS
第一遍不追求最精确,先把不可能的帧筛掉。
代码里用 16px patch 比较输入空场景和视频帧:颜色差异负责“像不像”,灰度梯度负责“结构还在不在”。为了不被生成出来的人体误伤,误差最高的 25% patch 会先被裁掉。
- patch_size = 16
把画面切成小块,比整图 MSE 更能抵抗局部遮挡,也方便观察哪些区域不可信。
- color + structure
颜色相似度和边缘结构相似度合成一个 score,既看材质色块,也看墙角、沙发边缘、家具轮廓。
- trim_fraction = 0.25
丢掉最坏的四分之一 patch:人物、局部生成伪影或短暂遮挡不会直接把整帧判死。
这一步只问:视频帧背景像不像输入 view?人物遮挡先不参与打分
16px patch颜色 + 边缘结构→
人物 / 伪影区域:裁掉保留:稳定背景和家具忽略:人物遮挡、局部生成伪影
先验证背景相似,再复用 CG 标定hierarchical_run / 实测配对
背景 patch 相似→SAM3 扣除人物区域→SIFT 只取背景特征→MAGSAC 检查背景几何相容
最终记录VIEW 00 → frame 015 → camera_id 00
复用输入 VIEW 00 的 K / R / T,并适配图像分辨率。背景匹配提供近似对应,不构成生成相机位姿的精确证明。
四个 view 的实际一对一分配;不要求时间先后一致
VIEW 00 → frame 015VIEW 02 → frame 106VIEW 03 → frame 052VIEW 06 → frame 000SIFT + USAC_MAGSAC / GLOBAL ASSIGNMENT
第二遍检查背景几何,建立视角对应。
粗筛只告诉我们“这帧大概像”。真正接回相机参数前,先用 SAM3 找到并膨胀人物区域,把它从比较中排除;再用背景上的 SIFT 特征和 MAGSAC 单应验证几何,最后防止两个 view 抢同一帧。
- SAM3 person mask
对 shortlist 候选帧分割人物,膨胀 mask 后得到 background mask;人物像素不参与后续背景相似度和几何特征提取。
- ratio test
只在背景有效区域提取 SIFT descriptor 做近邻匹配,过滤掉不稳定的重复纹理和错误对应点。
- USAC_MAGSAC homography
用鲁棒几何估计检查 inlier ratio、覆盖面积和重投影误差,确认家具/墙面关系仍合理。
- one-to-one selection
select_unique_assignments 最大化总分,但要求每个输入 view 使用不同 source frame。
匹配成功后,它就不只是图片了它会被包装成下游重建能读懂的输入
第一步背景稳定分background_score
→第二步场景一致性r_scene
→第三步有效视角active views
→第四步参与姿态共识equal initial view weights
默认只检查 r_scene > 1e−8 和输入有效性,通过后初始视角等权。人体融合另用姿态 membership、相机方向多样性与动态 IRLS,背景分不直接转换为人体权重。
SCENE_CONSISTENCY_ADAPTER
匹配结果成为相机对应与参与资格。
prepare_video_scene_consistency_results 会把已验证的视频帧写成标准 scene_consistency_result.json,并把 background_score 保留为 precomputed 的 r_scene。
- 保留 provenance
metadata 记录 source_frame_index、timestamp、person_mask、background_geometry 和 final_match_score,后面可追溯。
- 排除人体区域
结果显式标记 exclude_body_mask=true,让 scene score 代表背景/家具稳定性,而不是人物是否生成得像。
- 继续走原管线
prepare_video_reconstruction_scene 会把选中的含人视频帧复制进 inpaint/(目录名沿用,并非已做图像修补),连同 empty_views、masks 组装成自包含的新场景包并重写 cameras.json / scene.yaml,交给 body_fit、pose_consensus、body_fuse。
VALIDATION / WHY THIS IS NOT ENOUGH
图像输入能跑通,但一致性仍然太脆弱。
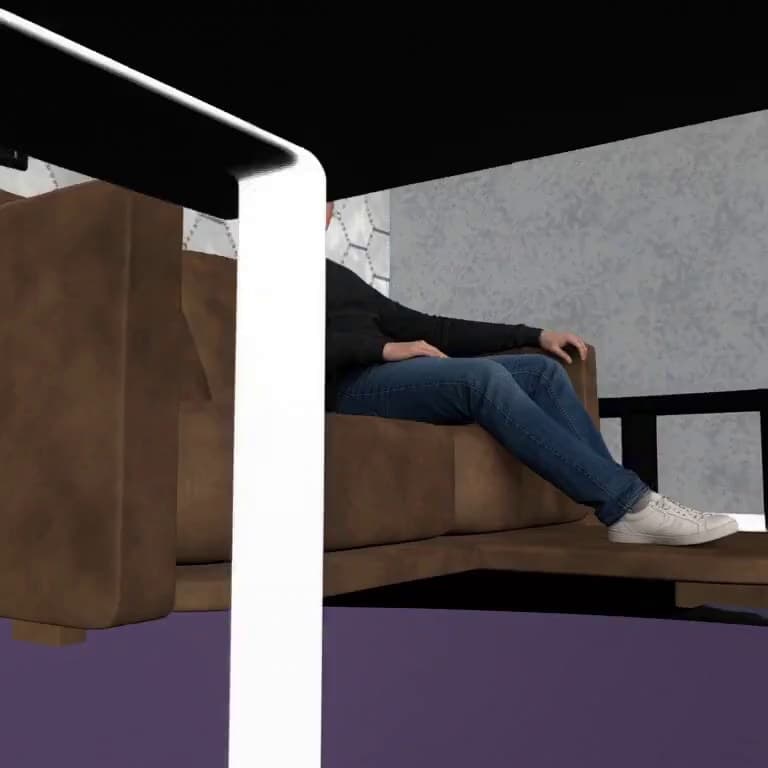
这里的输入仍然是参数化相机拍到的空场景 view,再加一张人物姿势参考图。为了逼近“同一个沙发、同一个视角、同一个人物意图”,prompt 被写得非常长;但测试结果会明显受提示词措辞、随机性和模型稳定性的影响。
对比视频可以更直观看到:人物会被生成出来,但人物动作一致性和场景背景一致性都不能稳定保证。
所以下一步换成“空场景运镜视频作为输入”:让模型先继承连续相机运动,再在同一段镜头里生成人物与家具交互。
compare0236.mp4 / generated frame vs. source view
VIDEO CONDITION / WHAT CHANGED
把静态图片输入换成连续运镜视频。
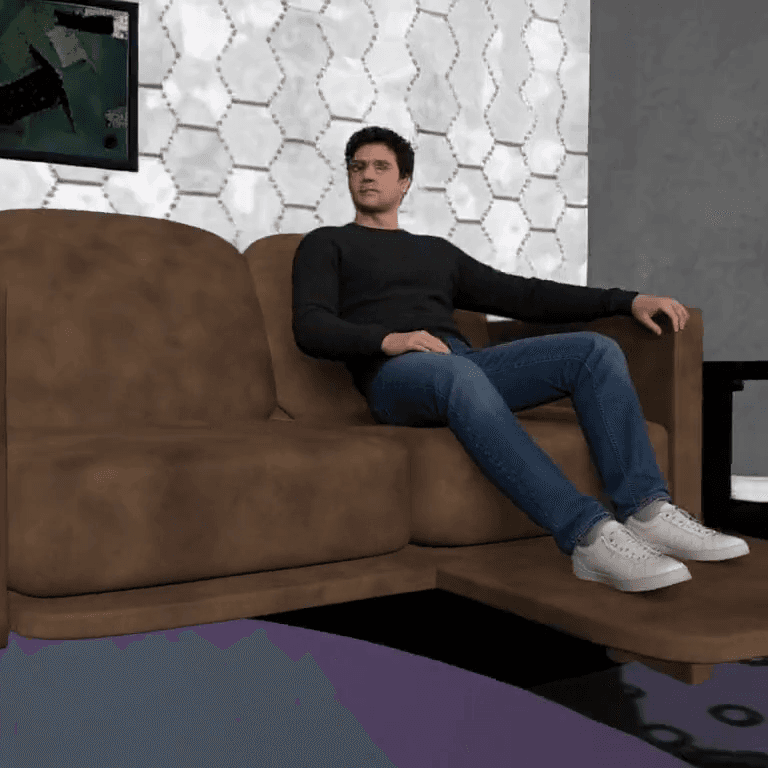
这一次不再要求 prompt 同时记住四个离散视角。输入改成一段空场景相机运动视频,再加一张人物动作参考图,让模型先继承连续镜头,再在同一段镜头里生成稳定的人物—家具交互。
- 输入 01参数化相机采集到的空场景运镜视频。
- 输入 02一张人物动作参考图,用来锁定坐姿和交互意图。
- 输出MiniMax H3 生成带人物的同运镜视频,视角连续性和场景稳定性明显更好。
读取真实重建记录…
独立历史案例:把穿进场景的身体推出去scene penetration / 非上方四视角运行后续
UNION SCENE SDF / POSITIVE_OUTSIDE
重建出来的人体,还要和场景实体互相避开。
interaction_opt_scene_penetration 不直接相信视觉上“差不多坐上了”。它把场景刚体合成 union scene SDF,再查询人体表面采样点是否进入 solid。
- vertices + face centroids
除了全部 18,439 个 MHR vertices,还会查 triangle centroid(合计 55,313 个查询点),避免薄面中间穿过家具却被顶点漏检。
- signed distance + gradient
sdf_m < 0 表示穿插,grad_world 给出推向自由空间的方向;优化只对穿进去的点产生 scene force。
- manifest + probes
NanoVDB 的单位、符号、band 和 inside/outside/surface probes 会先通过 preflight,失败就不会发布 refined body。
ROOT-ONLY → LOCAL REFINE
先移动整个人,再只开放受影响的关节。
如果一开始就让所有关节自由动,人体很容易为了不穿模而扭成不可信的姿态。所以求解器先用最少自由度修正整体错位,再根据剩余穿插点激活局部 DoF。
- root-only Adam
最多 50 steps,只优化外置 world rotation / translation,shape、scale、pose、hands、expression 都冻结。
- LBS support → active joints
重新查询 SDF 后,用穿插点的 skinning weights 找到受影响 joints、ancestors 和必要 hand block。
- evidence anchors
优化同时锚定 fused root、local SO(3)、world joints 和 per-view proposal residual,防止“防穿模”把原动作解释破坏掉。
穿模修正分两步,不是随便扭骨骼root first, joints later
01 / query SDF02 / root-only Adam03 / local refine
CHECKPOINT RANKING / SAFE PUBLISH
最后不是盲目输出,而是选择可发布的最好 checkpoint。
scene penetration 的目标不是把每个真实场景都强行修到完美,而是在安全边界内严格改善穿插,并把结果语义说清楚。
- no_op
初始查询就没有穿插:不跑优化,发布与 fused body 等价的独立副本,避免无意义地改动模型。
- ok
所有查询样本都达到非负 SDF——专指严格零穿插的最好情况。
- partial
穿插严格改善并通过安全 gate 即可发布,允许少量残留。这是正常可交付结果,不是降级失败。
- failed
hash、topology、camera、SDF band、数值有限性或 drift 约束不通过时,不会留下可被误用的 refined alias。
SOURCE-VERIFIED PROJECT MAP / 2026.08
YSynthetic
先看顶部三步理解项目在做什么;再点击任一阶段和步骤,查看真实输入、算法、代码文件、输出与当前完成度。
已自动化代码链路存在,可从明确输入生成标准 artifact。
需准备输入核心代码可运行,但素材、环境或模块调用仍需人工准备。
实验能力已有实现与测试入口,但还不是默认稳定交付路径。
待实现 / 待打通文档中明确为未来模块,或两个仓库之间尚无正式接口。
MOTIONBRICKS INTEGRATION / PATH_PLANNING
从人数与房间,得到每个人可执行的路线
这一层回答三个问题:哪里能走、一个有半径的人怎么走、多人同时出现时何时需要避让。
- 输入
- 场景文件、可选 mesh_path、栅格 resolution、max_cells。
- 实现过程
- planning_core.py 读取 OpenUSD;筛选与 upAxis 近似垂直的面、三角化并投影到两个水平轴;若未指定 Mesh,则选择候选中面积最大的地面;随后 rasterize 为布尔 walkable grid。
- 输出
- walkable 栅格、grid_origin、coordinate_axes、up_axis,以及可追溯的 floor mesh 列表。
- 代码位置
- path_planning/planning_core.py::load_floor · project_horizontal_faces · rasterize
当前状态已自动化;缺少 pxr 时还保留 usdcat 文本解析的兼容路径。
- 输入
- 真实 radius、G1 minimum radius、MotionBricks tracking padding、静态 clearance 与 walkable grid。
- 实现过程
- planning_radius = max(radius, g1_minimum_radius) + motionbricks_safety_padding;静态圆心地图再加 clearance,并由 erode_for_circle 对 walkable grid 腐蚀。实现还加入半格对角线的保守量,避免圆盘视觉上越过边缘。
- 输出
- 每个不同半径 agent 对应的一张 safe-centre map。
- 代码位置
- path_planning/plan_multi.py::planning_radius · static_planning_radius · planning_core.py::erode_for_circle
当前状态已自动化,并为 MotionBricks root 的自然摆动预留额外空间。
- 输入
- safe-centre map、吸附后的 start / goal、clearance_preference_weight。
- 实现过程
- clearance_preferred_astar 使用 distance transform 给靠边格子增加小惩罚;simplify_global_path 用 segment_is_clear 做 line-of-sight 简化,保留最远可直连路标。
- 输出
- agents[].global_path 与 global_path_length。
- 代码位置
- path_planning/plan_multi.py::clearance_preferred_astar · simplify_global_path
当前状态已自动化,是单人和多人两种模式共同的几何主线。
- 输入
- planning_mode = single_agent_static 或 fixed_speed_rvo。
- 实现过程
- single_agent_static 独立按主路线采样每个人的导航意图;fixed_speed_rvo 每个 time_step 在恒速圆周上采样方向,用 time-to-collision、预测最小距离、静态 sweep 与人物间连续 sweep 评分和淘汰候选。
- 输出
- 带统一时间轴的 agents[].trajectory,或明确的无解原因。
- 代码位置
- path_planning/plan_multi.py::simulate_independent · velocity_candidates · choose_velocities · simulate
默认:single_agent_static已自动化只声明每人的独立静态路线和时钟;动态避让交给下游 MotionBricks 预测控制。
备选:fixed_speed_rvo已自动化规划阶段保持速度模长,只在线改变方向;找不到任何安全方向时直接失败,不伪造等待。
当前状态两种模式均已实现。项目默认 single_agent_static,因为最终安全更应根据 MotionBricks 实际 root,而不是只相信规划圆心。
- 输入
- global_path、trajectory、场景轴约定和每个 agent 的半径。
- 实现过程
- validate_trajectories 检查静态边界、恒速约束和人物对的连续最小间距;结果写明 success、termination_reason、planning_mode 与 collision_free 子项。
- 输出
- paths.json:global_path、trajectory、velocity、action、arrival_time、validation 和 static_map。
- 代码位置
- path_planning/plan_multi.py::validate_trajectories · make_result · plan_scenario
当前状态已自动化;下游以它为唯一规划契约,不从截图或曲线反推数据。
为什么现在还不是“一键从多人任务生成家具交互动画”
两个仓库内部都有可运行模块,但下面四个接口仍需要补齐。它们也是下一阶段最清晰的开发路线。
G1 动画 → MHR / SMPL-X
MotionBricks 输出 G1 骨架序列;YSynthetic 当前消费 MHR / SMPL-X 静态人体 evidence。两个仓库里还没有正式的骨骼映射、比例校准与逐帧 retargeting 模块。
静态 interaction_opt → 序列优化
当前 scene penetration 面向一个融合人体 artifact。要处理整段走到沙发并坐下的动画,还需要逐帧 SDF、时序平滑、脚底接触和接触保持。
人工素材生产 → 自动 scene_render / inpaint
相机轨迹、空场景渲染、MiniMax / ComfyUI 调用与视频下载仍未形成正式模块;网页中的素材验证不能等同于库内自动化。
独立模块 → 一键 recipe
YSynthetic 明确采用 module-first 设计,各 runner 不自动运行上游依赖。还需要 recipe / orchestrator 负责状态恢复、失败重试和跨环境调度。